 寒蝉 Hancic
数据引擎:从 Tushare 到 parquet
量化系统的数据引擎干的事很朴素:把行情数据从数据商搬到本地,搬得正确、搬得可重复。正确排在前面——回测再快,喂进去的数据是错的,结论全是垃圾。数据慢一点无所谓,错不能忍,静默的错更不能忍(错得大声你还能发现)。这篇是给正在搭自己数据管线的技术人看的。
这套系统是个人量化研究系统:日线、盘后批处理,每天收盘后拉数据、算因子、跑策略、出报告,只产信号和分析报告,不下实盘单。跑在一台 2 核、1GiB 内存的云主机上——内存小是这篇里好几个决策的硬约束。数据源 Tushare Pro,输出 parquet 长表。接下来的三个决策:怎么拉、怎么防错、怎么累积。
按交易日拉,不按股票拉
直觉是「对每只股票,拉它的全部历史」。我反过来:对每个交易日,拉全市场。
差别在调用次数。A 股五千多只,窗口约 880 个交易日。按股票拉是五千多 × 3 次调用(行情、复权、涨跌停各一次),按交易日拉是 880 × 3——Tushare 按积分计价,前者是后者的六倍。而且 daily 接口一次能返回某交易日的全市场,接口本身就按天组织。
每天主路径三个接口拼成一行:daily(价量)、adj_factor(复权因子)、stk_limit(涨跌停价)。多线程并行拉,一个共享限流器统管总速率——拉快和限流是一件事的两面。
代价是接口和文档总有出入,每处都要适配:列名对不上、日期是 YYYYMMDD 字符串、停牌用缺行表达(当日无行)。都不难,碎而已。
数据模型与体量
落盘一张长表,symbol × trade_date 一行,13 列:价量六列、复权因子、涨跌停价、ST 标记、停牌标记——前三个接口提供,后两列单独补(stock_basic / suspend_d)。另外 trade_cal 决定拉哪些天,daily_basic(市值、换手率)单独一张表喂因子。
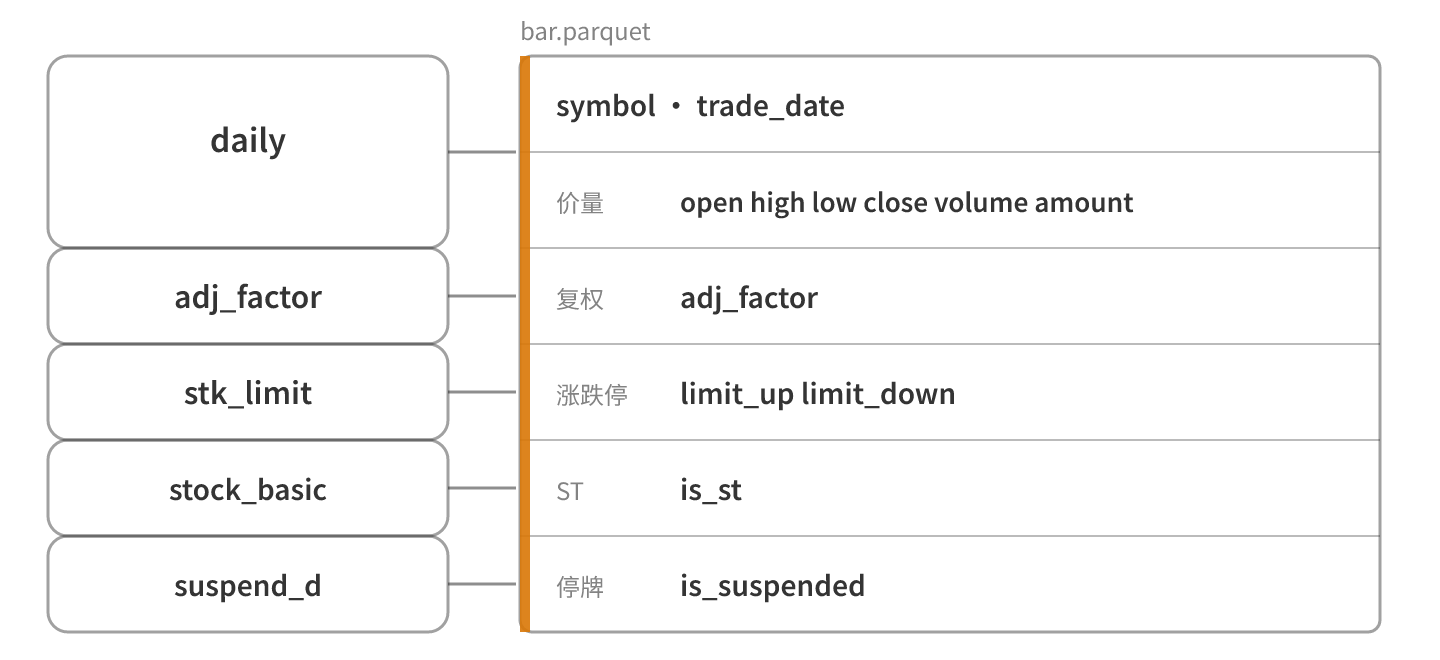
存 parquet 而不是 CSV / JSON,图列式存储:回测和因子计算只消费少数几列(close、adj_factor 这类),列存只加载用到的列。现在的体量(每次拉完 meta.json 记录实测值):
- 覆盖 5695 只,区间 2023-01 ~ 2026-08
- bar 约 470 万行 / 180MB,daily_basic 同量级
- 每天新增约 5400 行
单文件、单进程读得动,不需要数据库。行数比「股票 × 天数」少约 6%,正是停牌缺行的真实代价。meta.json 还记着 data_version——数据最新日期,报告头跟着它走,任何一份报告都能指回当时的数据;增量语义下每次都在改旧文件,所以拉数后自动留一份按日期命名的备份。
写盘前校验:拦不住的就显式修
校验放在写盘前:分片拉完先 validate 再落盘。按严重程度分级——列缺失、量价非正直接抛错(这种错修不了,重拉);OHLC 关系异常少量夹回修复、留日志,多了才终止(为个位行脏数据卡死整个回补任务不值);后复权价跳变有阈值地抓。
坏数据要么被拦住,要么被显式修掉留日志,不能无声无息混进因子计算。校验损失一点拉数速度,换掉「用错数据算了三天因子」的排查成本。
校验规则自己也要过真实数据:设计稿曾写「复权因子单调」,实则分红日因子会小幅下降——改成后复权价连续性校验,阈值按板块区分,还要认几类合法的大跳变(无涨跌停限制日、长期停牌复牌、涨跌停收盘),否则天天误报。
增量:累积而不是覆盖
初版是全量重拉。50 票时只要几分钟,全市场估算约 40 分钟,当时判定增量暂缓。部署后真问题来了:配置里 END_DATE 冻结,调度器每天跑,数据最新日期永远不变——「一周不盯也能跑」跑了个寂寞。修两件事:
**滑动窗口 **:调度日更时终点取最新交易日,起点跟着窗口平移,回测口径不变;研究模式走固定窗口,可复现。
**增量更新 **:拉之前只读旧文件的日期列,找出窗口缺的交易日,只拉缺失部分——任何一次调用都是累积而不是覆盖,窗口漂移、补早期缺口都自动处理。
增量把合并变成真正的工程问题,分三种情形:新老日期无重叠(补早期 + 补尾部)直接拼接,去重纯属浪费;新数据覆盖全部旧日期直接替换文件;只有部分重叠才做去重——而千万行的唯一化在这台 1GiB 机器上会直接挂(实测),所以按标的哈希分桶、桶内去重再合,内存峰值只到单桶。
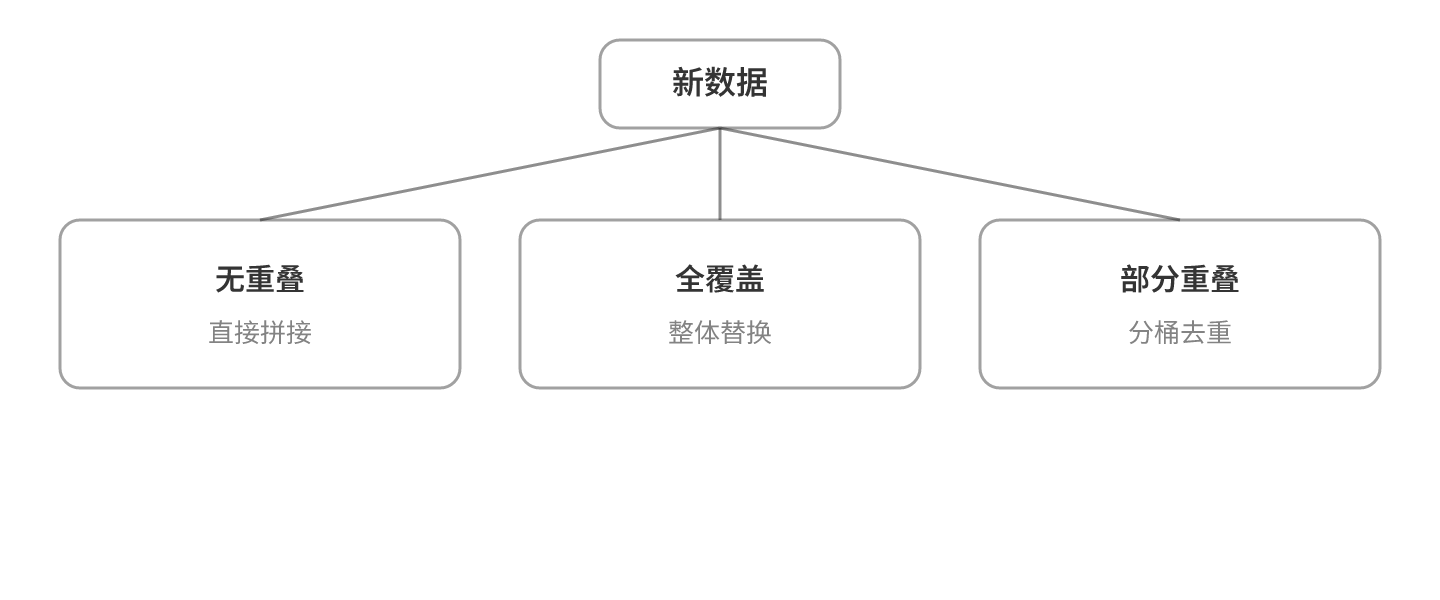
配套断点续拉:区间切成片,每片拉完原子落盘,失败重跑只补缺失片——全量重拉 40 分钟,中断重来最亏。
小结
让拉数据这件事可断点、可校验、可重来:按交易日拉控制调用成本,契约以真实返回为准,写盘前校验挡住静默错误,增量合并让数据越积越安全,meta.json 让每份报告都能指回它喂的数据。数据慢可以接受,数据错得没人知道不行。


