 寒蝉 Hancic
可观测性:分布式系统里的盲人摸象
用户在页面上转了三秒。请求从网关进来,穿过订单、库存、支付、风控、通知五个服务,然后返回。你要回答的问题很具体:这三秒花在哪儿。
单体时代这问题不难。一个进程,一个日志文件,调用栈从上到下排着,grep 一个请求 ID,故事就完整了。性能有问题,看一台机器。
拆成五个服务之后,情况变了。数据比单体时代多得多,但这些数据对不上。
三个断裂
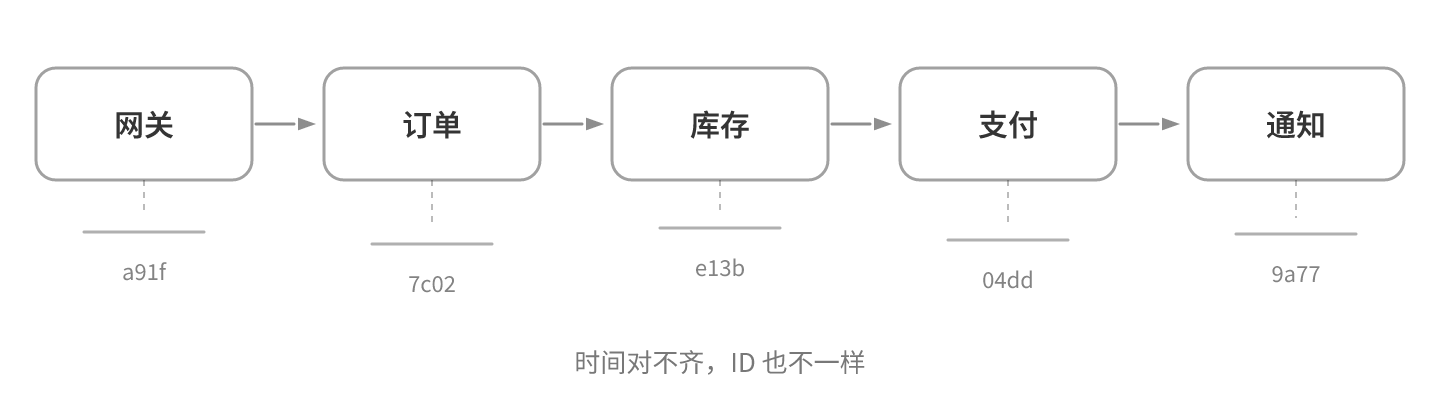
时间对不齐。 五台机器的时钟各走各的。NTP 校时能把误差压到毫秒级,压不到零。跨服务的一次调用本身就在几十毫秒这个量级。两个服务的日志时间戳差几十毫秒,谁先谁后就看不出来。查一个竞态问题,你要知道「A 写完 B 才读到」,日志给不了这个答案。
痕迹散了。 一次请求的脚印分布在五台机器、五个日志文件、五套格式里。同一个请求在不同服务里的 ID 还不一样:你在订单服务里看到的那个 ID,到库存服务里搜不到。
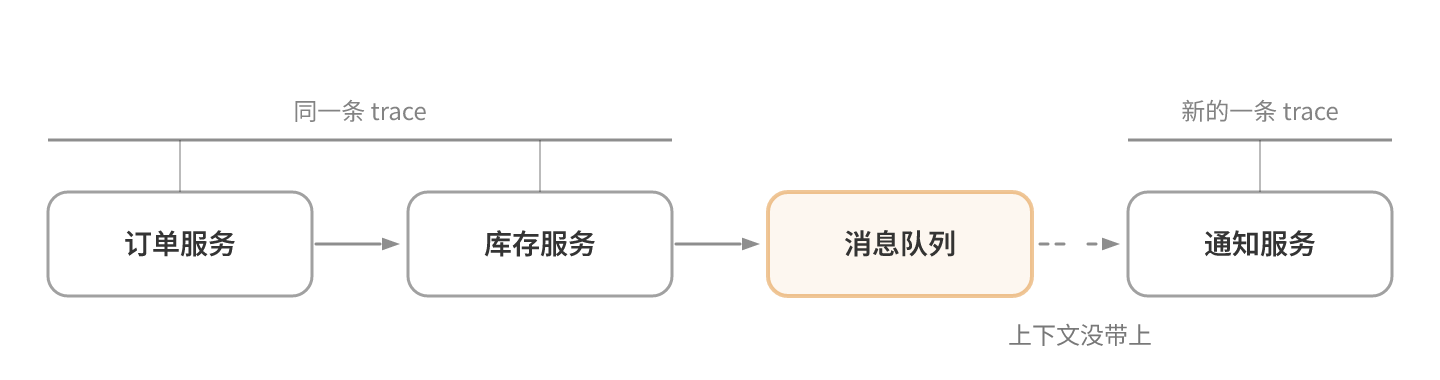
因果断了。 调用方只知道自己发出去了,不知道下游发生了什么。走到消息队列这种异步边界,因果关系直接消失:生产者写了一条消息,消费者什么时候读的、读了几次,两边互不知情。
三件套的尺度
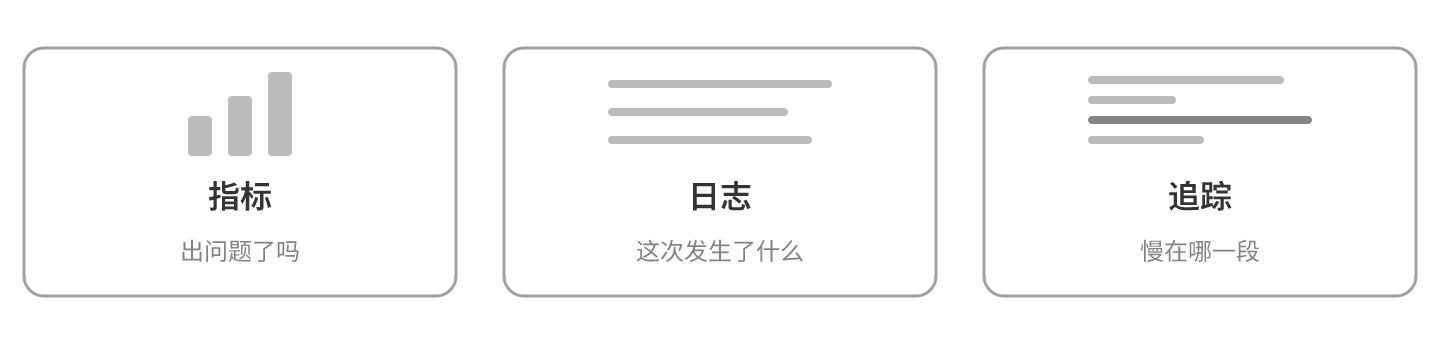
日志、指标、追踪经常被当成三个可以互相替代的方案。它们看的是三个尺度。
指标 是聚合的数字。QPS、P99、错误率、队列深度。看趋势、做告警、估容量,它最合适。代价是丢细节。P99 从 200ms 涨到 2s,指标告诉你有问题,不告诉你是哪批请求、卡在哪一段。
日志 是细节的原文。一次请求做了什么,参数是什么,报了什么错。想知道具体发生了什么,只有日志能给。代价是散、量大、贵,而且你得先知道去哪个文件里找。
追踪 是一次请求的完整时间线。谁调了谁,每段花了多久,哪一跳是瓶颈。它填的正好是前两者中间那个空:从「有问题」走到「在哪一段」。
三个都要。
串起来才算数
装齐三件套,不等于能定位问题。
第一件事是统一 ID。入口生成一个 trace_id,然后一路传下去:HTTP 的 header、线程池、消息队列的消息头。这条链断在任何一跳,追踪就断在那儿。异步边界最容易断:生产者没把上下文放进消息,消费者那边就是新开的一条链,看着像一次全新的请求。
第二件事是采样。全量存追踪,存储成本很难接受;不采样,什么都留不下。中间只有取舍。头部采样在入口决定这次记不记,便宜,但会漏掉慢请求。慢请求是少数,按比例随机采,样本里大部分是正常请求,出事的那次很容易不在里面。尾部采样先把数据留一会儿,等请求结束再决定留不留,异常请求能保住,代价是要先攒着。
第三件事是维度统一。指标上的标签、日志里的字段、追踪上的属性,用同一套命名才有意义。指标按「服务名」分,日志按「应用」分,追踪按「component」分,三张表就对不上。
反面案例:三件套都有,半天没定位
某个系统的接口 P99 从 200ms 涨到 2s。三样工具都在。
指标看到了 P99 变差。点进追踪,采样到的那几条链路,每段都正常。日志里 grep ERROR,一条没有:请求都成功了,只是慢。查了半天。
后来才把几个事实拼起来:慢请求只占千分之几,1% 的采样率下基本采不到;日志只记 ERROR 和开始结束,中间没有打点,慢而成功的请求什么都没留下;指标只有整体 P99,没按下游服务拆开,看得到「慢」,看不到「哪个下游慢」。
三份数据各自成立,拼不出一条线。追踪里的样本正常,指标里的数字是整体的,日志里只有错误。
后来改了三个地方:采样加耗时兜底,超过阈值的请求强制保留;日志对下游调用打点并带上 trace_id;指标按被调服务分维度出 P99。三处改动都不大。
一个检验标准
检验标准只有一个。线上报警响了,从看到报警到说出根因,你用了多久。
超过半小时,或者中途要拉几个人各翻各的日志,就是不够。更狠一点的检验:能不能不看代码,只靠数据猜到是哪个依赖慢。
小结
分布式的排查难点在数据对不上。时间基准不一致,请求 ID 不一致,维度不一致,三份数据各自成立,拼不到一起。可观测性要做的,是让日志、指标、追踪落在同一个 ID、同一套维度、同一个时间基准上。异步边界和采样策略最容易丢线索,而它们恰好是出事时最需要线索的地方。


